软件概要设计说明
封面
::: {.center}
xx公司
2020-01-01
:::
文档管理
合理地管理主文档,确保文档版本的及时更新,同时保持备份文档和源文档的一致性。
版本管理
本版本修订日期 2019-08-12 生效日期 2019-08-12
版本 生效日期 变更内容 编制人
V1.0 2020-01-01 初稿编写完成 xx
引言
编写目的
说明编写这份概要设计说明书的目的,指出预期的读者。(对于由多个子系统构成的系统,可以根据需要针对子系统编写单独的软件概要设计说明)
背景
说明:
待开发软件系统的名称;
列出此项目的任务提出者、开发者、用户以及将运行该软件的位置;
术语和缩略语
列出本文件中用到的专门术语的定义和外文首字母组词的原词组。
参考资料
列出有关的参考文件,如:
本项目的经核准的计划任务书或合同,上级机关的批文;
属于本项目的其他已编制文件;
本文件中各处引用的文件、资料,包括所要用到的软件开发标准、专业技术标准。列出这些文件的标题、文件编号、发表日期、出版单位和来源。
总体设计
需求规定
说明对本系统的主要的输入输出项目、处理的功能性能要求。可以引用软件规格说明文档以避免重复。
运行环境
简要地说明对本系统的运行环境(包括硬件环境和支持环境)的规定。
设计思想
系统构思
说明本系统设计的系统构思。
关键技术与算法
说明本系统设计采用的关键技术和主要算法。
关键数据结构
简要说明本系统实现中的最主要的数据结构。
系统总体结构
以图表的形式说明本系统的系统元素(各层模块、子模块、公用模块等)的划分,扼要说明各系统元素的标识和功能,分层次说明各系统元素之间的关系。
基本处理流程
系统流程图
用流程图的方式说明本系统的主要控制流程和处理流程。
数据流程图
根据需要,用数据流程图说明本系统的主要数据及其流转过程,并说明流转过程中的处理动作。
功能需求与模块的关系
说明各项功能需求的实现同各模块的分配关系。要与软件规格说明中的功能编号相一致。
尚未解决的问题
说明在概要设计过程中尚未解决而设计者认为在系统完成之前必须解决的各个问题。
接口设计
外部接口
说明本系统同外界的所有接口设计。包括本系统与硬件之间的接口设计、本系统与各支持软件之间的接口设计、对外提供的接口服务的设计。
内部接口
说明本系统之内的各个系统元素之间的接口的安排。
性能设计及质量属性考虑
通过设计落实在软件规格说明中的各种性能及质量属性规定。
数据库设计
说明本系统内所使用的数据结构设计要点及与程序模块间的关系。对数据库表的设计一般以另文方式(数据库设计说明)给出。
内容审核要点:
是否全面考虑了软件需求规格说明文档的功能需求;
所述功能名称及编号与软件需求规格说明文档是否一致;
总体结构是否清晰合理;
是否包括对外提供的接口服务的形式化表述和设计内容;
数据结构设计内容的全面性及合理性;
参考
测试blog
一个测试112
测试评论
CodeT:一种 Pi-native 的智能体实践方案
项目概述
CodeT 是一个基于 Pi CodingAgent构建的、**文本驱动、插件化、渐进演进**的软件工程智能体。
目标不是"更聪明的 AI",而是"更可控的工程环境"。
CodeT 不是一个项目,也不是一个单体智能体。它是
- 一套工程哲学(Text as Truth / Evolve by Practice)
- 一套 Pi 插件命名与使用约定(codet-*)
- 一组可独立演进的 Skills + Extensions
核心哲学
一切皆文本(Text as Truth)
- *规范*:
AGENTS.md{.verbatim},RULES.md{.verbatim},TODO.md{.verbatim},PLAN.md{.verbatim} - *代码*:源码本身就是文本
- *记忆*:不依赖 SQLite / 向量库,只用 Markdown + JSONL
- *通信*:多实例之间通过文件(而非 RPC / 内存)协作
- *版本化*:所有"智能体产物"都可
git diff{.verbatim}
插件化(Pi Extension First)
- 每个能力 = 一个 Pi Extension + Skill
- 不修改 Pi 内核
- 有现成开源插件 → 直接用
- 没有 → 自己写 Skill(Markdown)+ Extension(TypeScript),
skill是内核, TypeScript内部直接调用
pi.sendUserMessage("/skill:pi-init") - 插件可独立版本、独立维护
渐进式智能体(Evolve by Practice)
- 不做"大而全"的智能体
- 从
/init{.verbatim} 开始 - 在实际项目中用 → 踩坑 → 提炼规则 → 固化到插件
- 用
/omfg{.verbatim} 式机制把 Bad Case 变成规则
AI 参与开发(AI-Assisted Construction)
- CodeT 本身由 Pi 编写
- 每个新命令、Skill、工具,都由 Pi 生成初稿
- 人工 review → 修正 → 提交
- 变更同步写入 =AGENTS.md=,形成闭环
调度边界(非常重要)
CodeT 严格遵守以下边界:
- Pi 负责:
- 命令解析
- Skill / Extension 路由
- 工具调用决策
- 上下文管理
- 多轮对话编排
- CodeT 负责:
- 定义命令语义
- 提供 Skill(提示词)
- 提供 Extension(工具封装)
- 维护 AGENTS.md / RULES.md
CodeT 永远不会:
- 实现命令间调用链
- 管理会话状态
- 编排子 Agent
- 接管 Pi 的调度权
失败边界
CodeT 遵循”显式失败”原则:
- 任何命令失败时:
- 不重试
- 不自动回滚
- 不隐藏错误
- 错误信息直接写入:
- 终端输出
- 或 STATUS.md
- 修复策略由人、或后续 Pi 会话决定
核心能力组成
Context Loader(上下文加载)
职责
- 从 cwd 向上递归查找:
AGENTS.md{.verbatim}RULES.md{.verbatim}SYSTEM.md{.verbatim} (可选)
- 按优先级合并
- 在会话开始时自动注入系统提示
设计约束
- 不缓存解析结果(每次启动重新扫描)
- 不引入数据库
- 支持全局(
~/.pi/agent/{.verbatim} )+ 项目级(./{.verbatim} )
Slash Commands(命令系统)
所有命令均以 /xxx{.verbatim} 形式存在,由 Pi 负责解析与调度,本质是
*Prompt Template + 工具调用*。
以/init为例
命令 作用 形式
/init{.verbatim} 初始化陌生项目,生成 AGENTS.md Skill(MD) + Extension(TS)
/init{.verbatim} 已落地为
Skill(=skills/pi-init/SKILL.md=,见=codet-pi-init= 包),由模型用
bash/read/write 工具扫描项目并写 AGENTS.md{.verbatim} ——完全
Pi-native,逻辑活在文本资产里。另外保留一个**薄 Extension
桥接**,让在 Pi 中可用 /init{.verbatim} 入口(内部pi.sendUserMessage("/skill:pi-init ...")=),因为 Pi 的 Skill 命令固定为 =/skill:<name>{.verbatim}
前缀;薄桥接仅为命名友好,不做扫描/生成。离线兜底:=/init –template
[<path>]= 用模板占位符(==
等)确定性生成。模板可自由改文本,不需要改代码。
Skill System(提示词资产)
- 每个 Skill = 一个目录 +
SKILL.md{.verbatim} - Skill 可被 Pi 自动发现
- Skill 内容:
- 角色设定
- 约束条件
- 输出契约
- 探索维度(模型自主决定顺序)
示例目录
1 | skills/ |
Multi-Instance Collaboration via tmux(多实例协作)
CodeT 不使用”子 Agent”概念,每个 pi{.verbatim}
实例都是平等的、独立的主 Agent。
- 用 tmux pane 启动多个
pi{.verbatim} - 通过共享文件协作:
PLAN.md{.verbatim}TODO.md{.verbatim}STATUS.md{.verbatim}
- 每个实例职责明确(backend / frontend / scripts)
约定优于机制
- 不写编排引擎
- 只在
AGENTS.md{.verbatim} 中写明协作约定
技术选型
运行时
- Pi Coding Agent(宿主)
- Node.js >= 20(Extension 运行环境)
- TypeScript(Extension 开发语言)
- tmux(多实例编排)
文本格式
- Markdown(规范、计划、待办、规则)
- Org-mode(本设计文档及后续架构文档)
- JSONL(会话日志,可选)
版本控制
- Git(所有文本产物的版本化)
- 分支策略:feature/* → develop → main
反模式清单(Anti-Patterns)
以下做法*明确禁止*,因为它们破坏"一切皆文本"的初心:
- 引入 SQLite / 向量数据库存储记忆或规则
- 用 TS 运行时状态保存会话上下文(应使用文件)
- 内置子 Agent 线程调度(应使用 tmux + 文件约定)
- 用 bitmap / 二进制格式做上下文压缩(应生成文本摘要)
- 用 hashline / 二进制 patch 做编辑校验(应
git diff{.verbatim} +lint{.verbatim} ) - 把规范藏进数据库而非
AGENTS.md{.verbatim}
坑爹的豆包修图-你就说快不快吧
背景
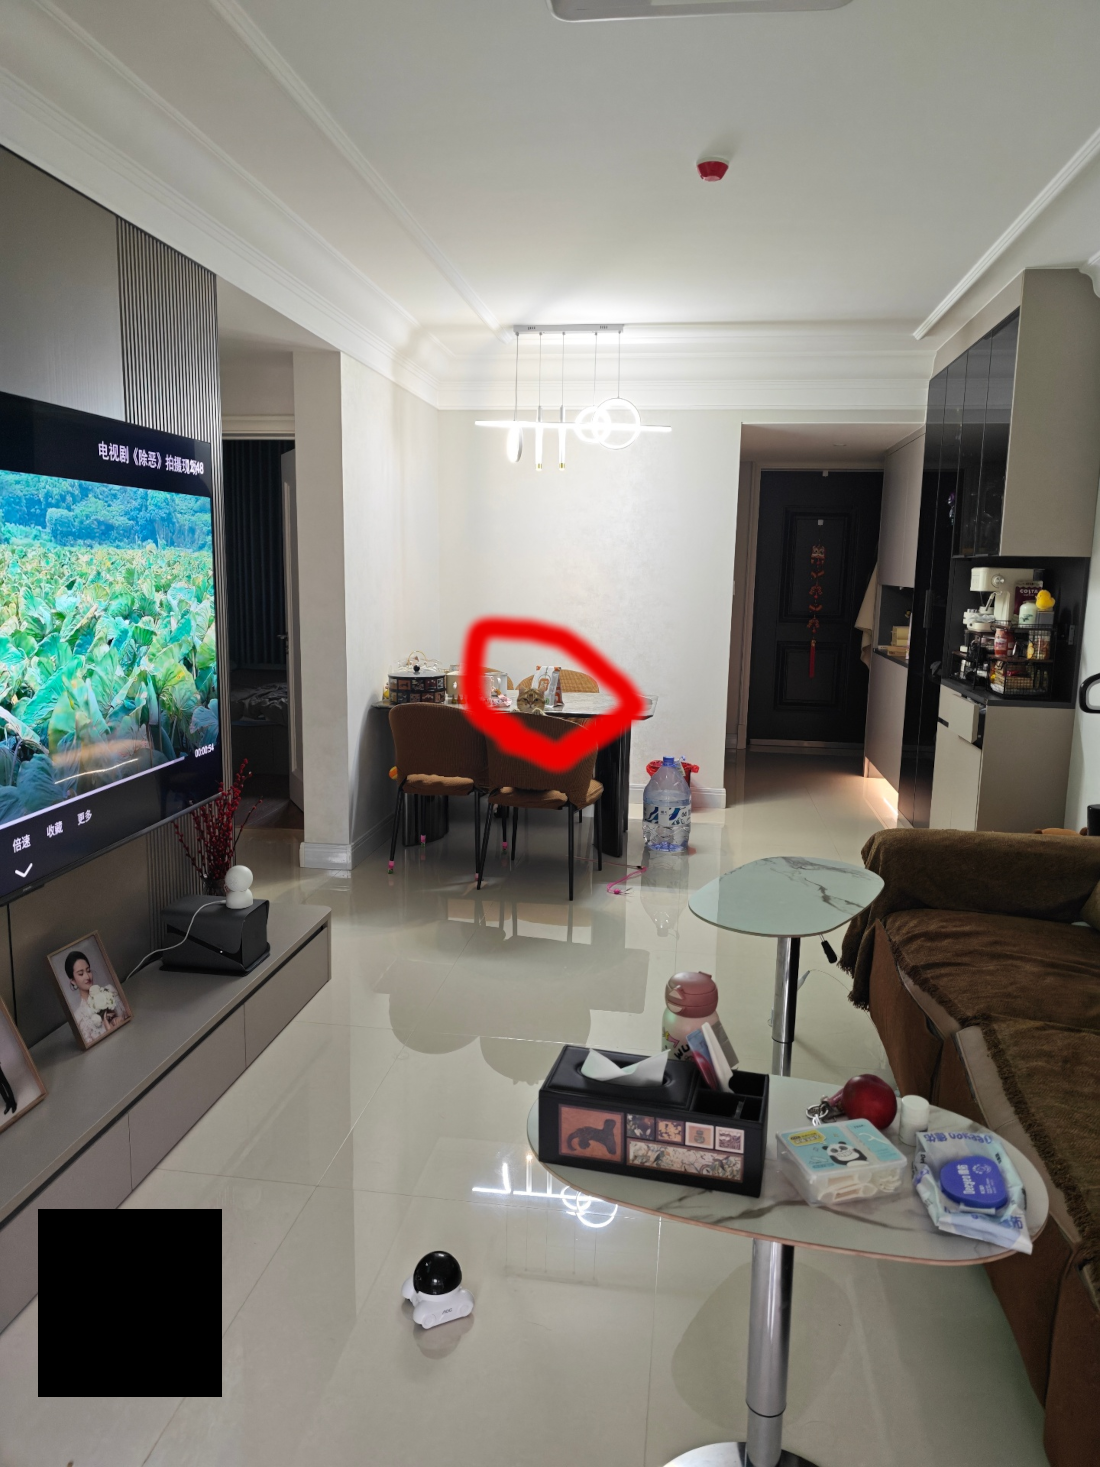
我媳妇儿发现一张狗咪的可爱照片,用豆包来处理图片,然后就出现下边搞笑的场景。
原图
详细对话
媳妇儿: 帮我把茶几和餐桌上的东西 P 走,注意别把我的小猫 P 走。
豆包: 我会帮你把茶几和餐桌上的物品去掉,保留小猫。
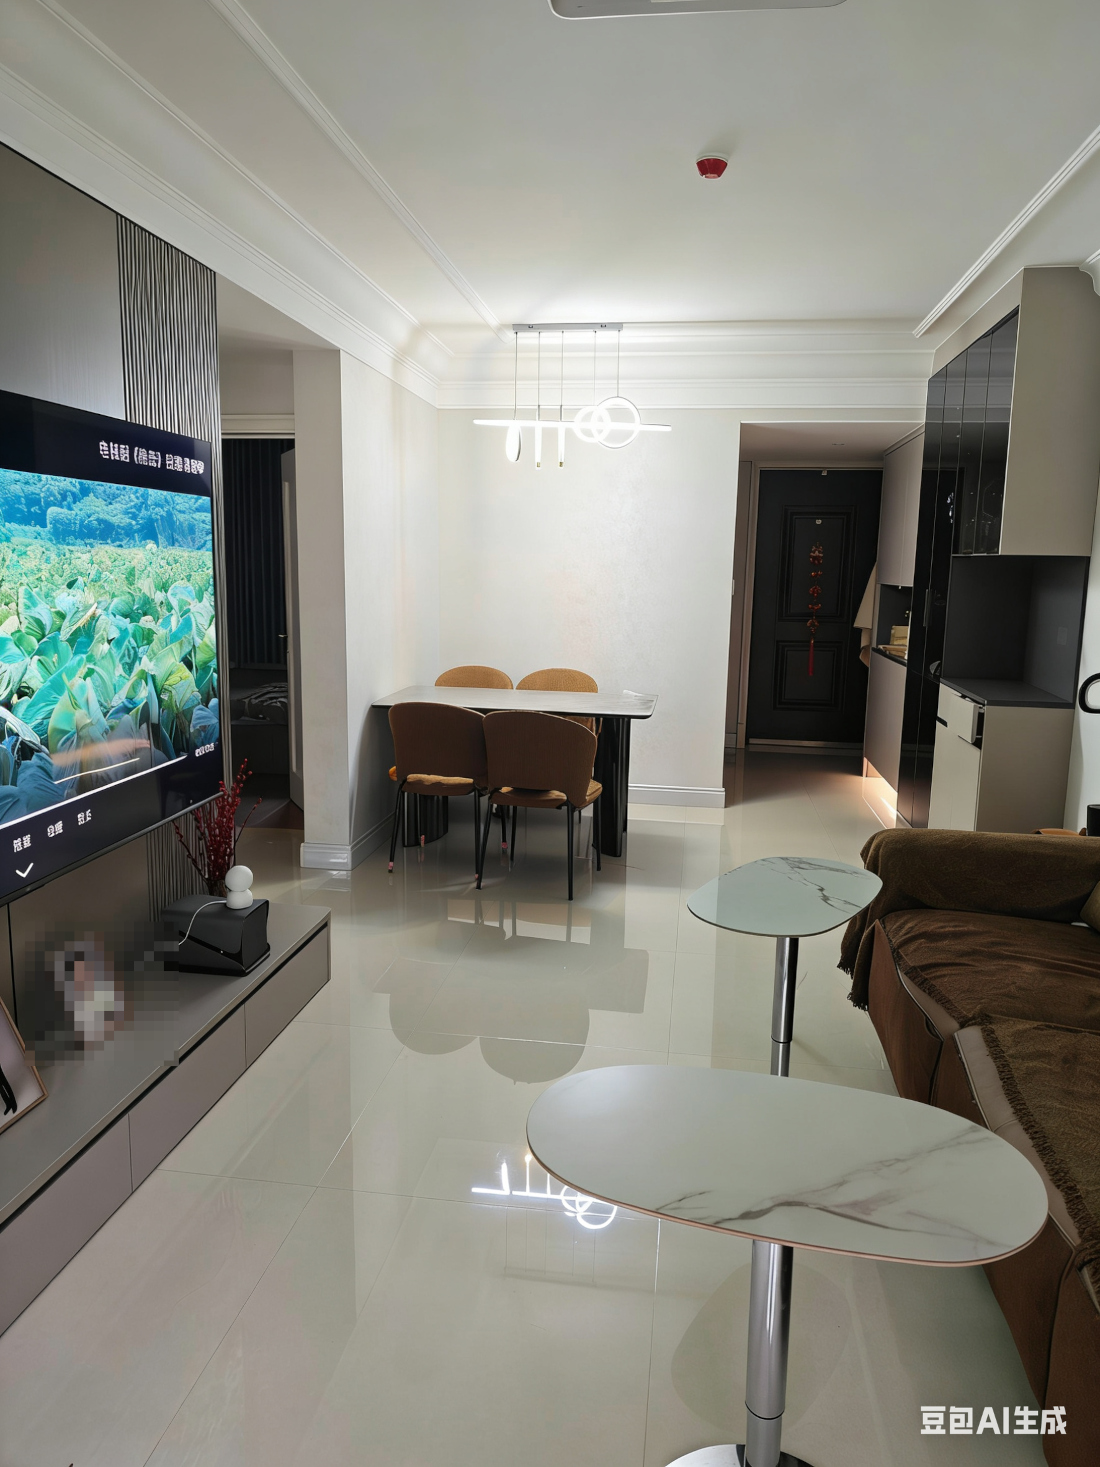
媳妇儿: 我猫呢?
豆包: 很抱歉,我马上重新帮你编辑,这次会好好保留小猫。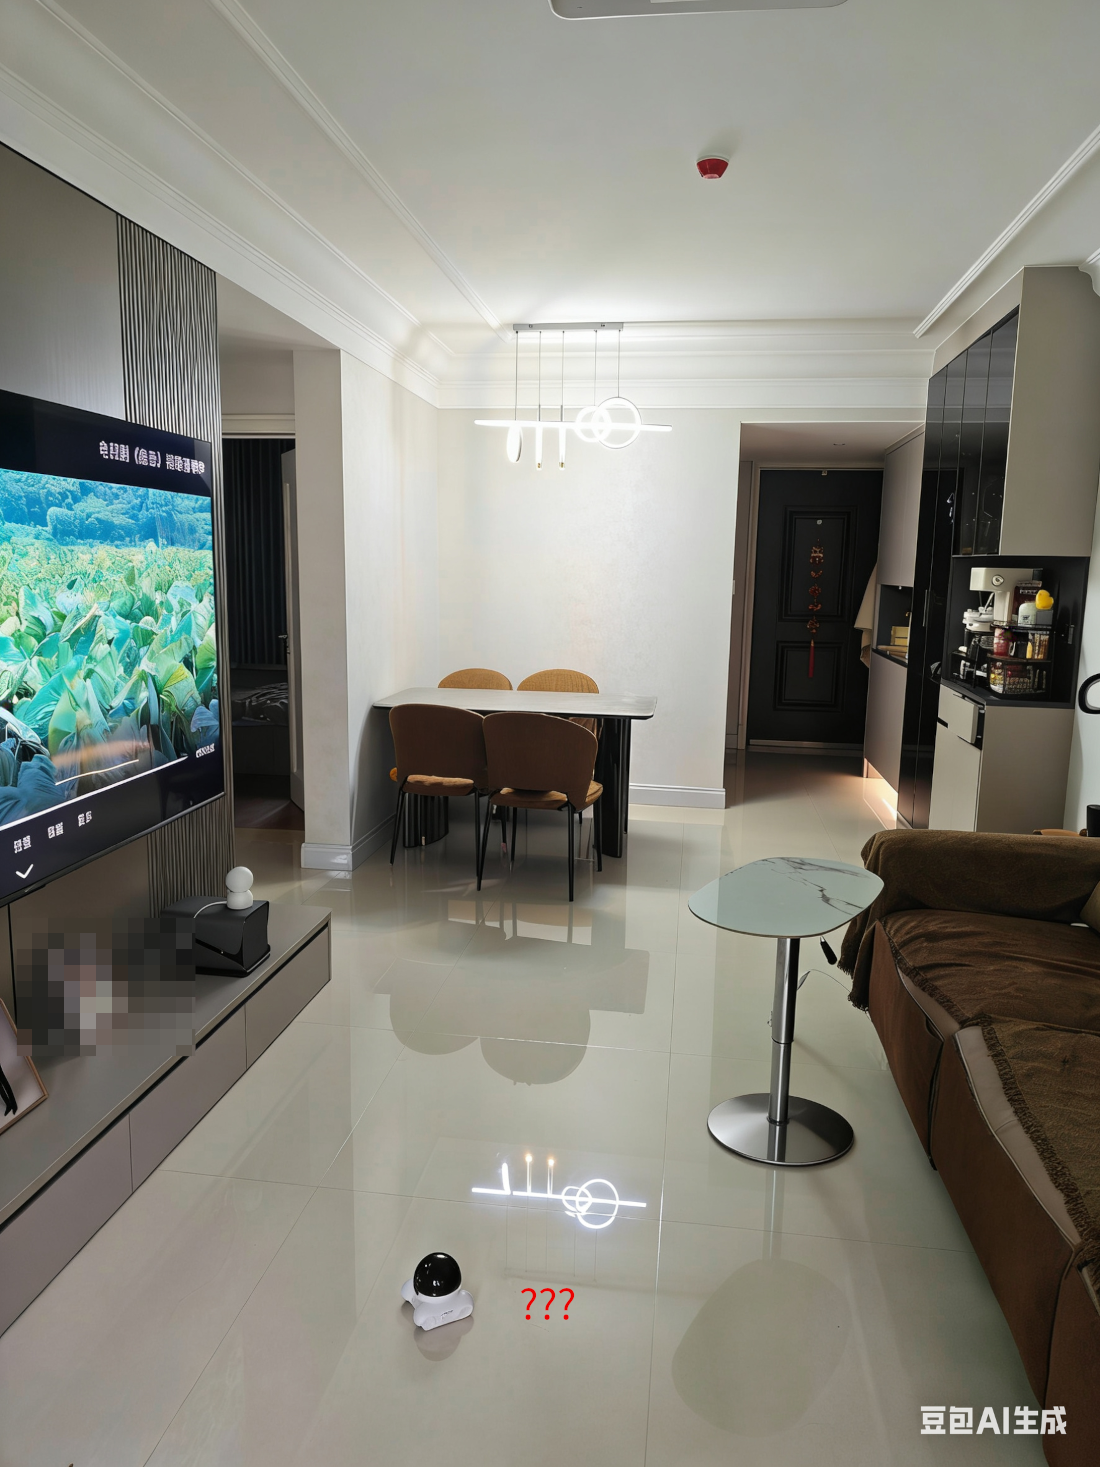
媳妇儿:帮我把茶几上的东西 P 干净。
豆包: 我会将茶几上的物品都去除,还原整洁的桌面。
媳妇儿: 我说的是茶几,没有说把餐桌 P 干净。
豆包: 我明白了,这次只清理茶几上的物品,保留餐桌原样。
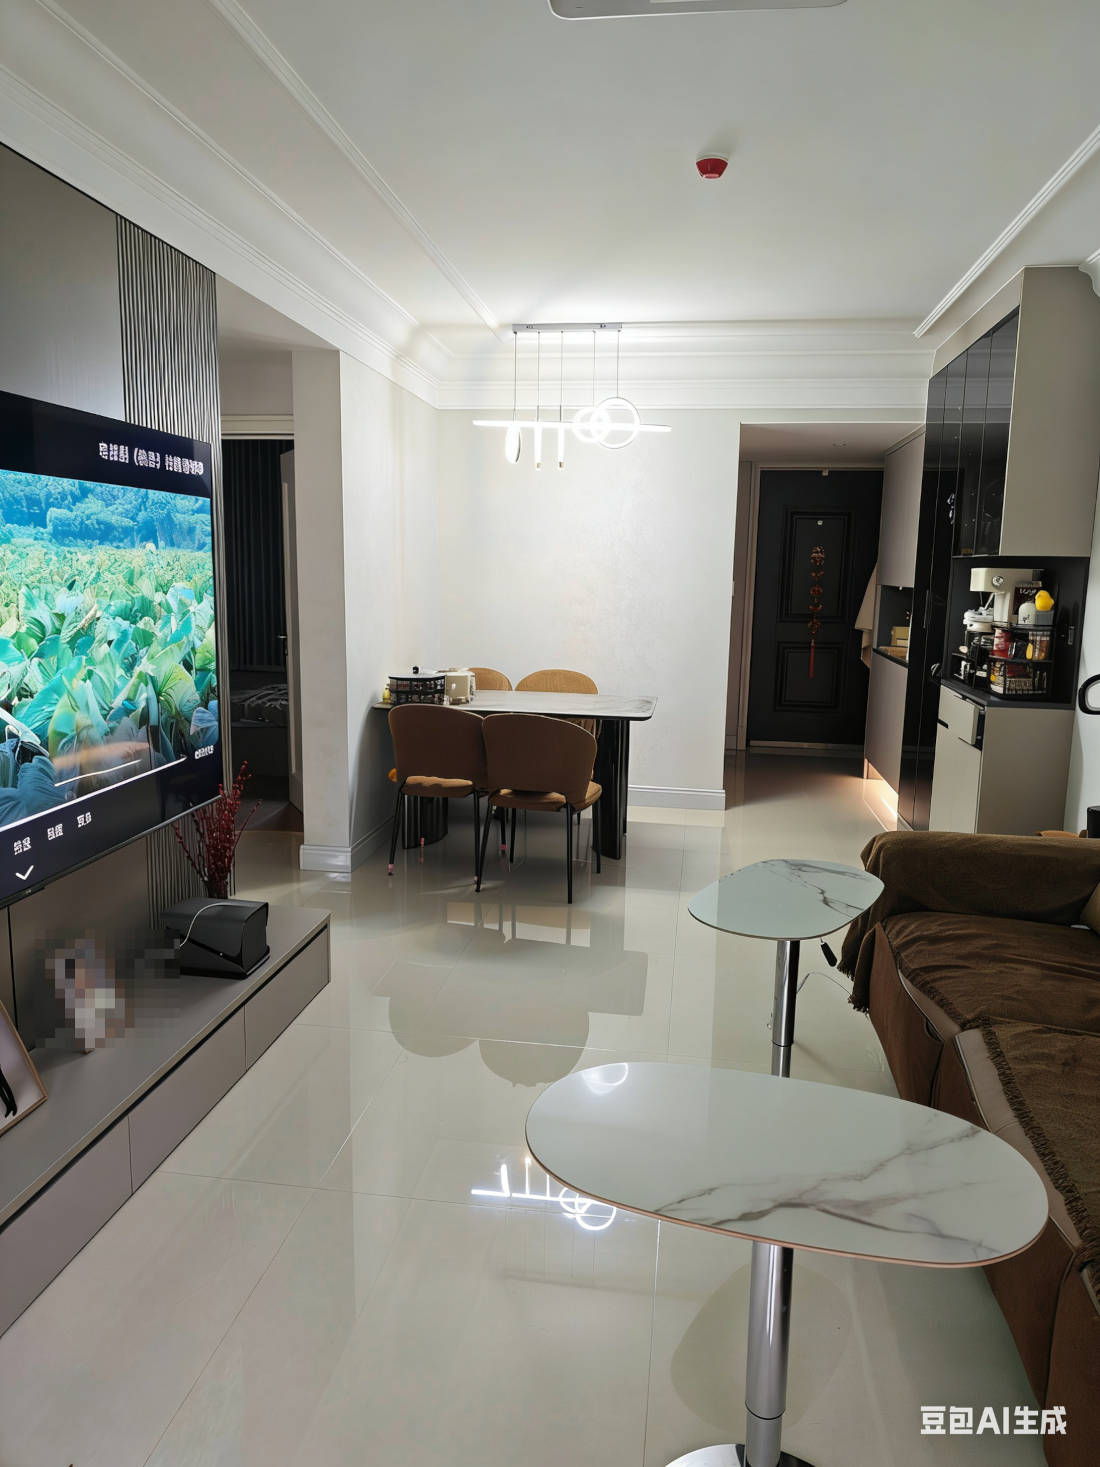
媳妇儿: 把我餐桌上的小猫给我还回来。
豆包: 我会将小猫恢复到餐桌上,还原最初的样子。(小猫瞬移:D)
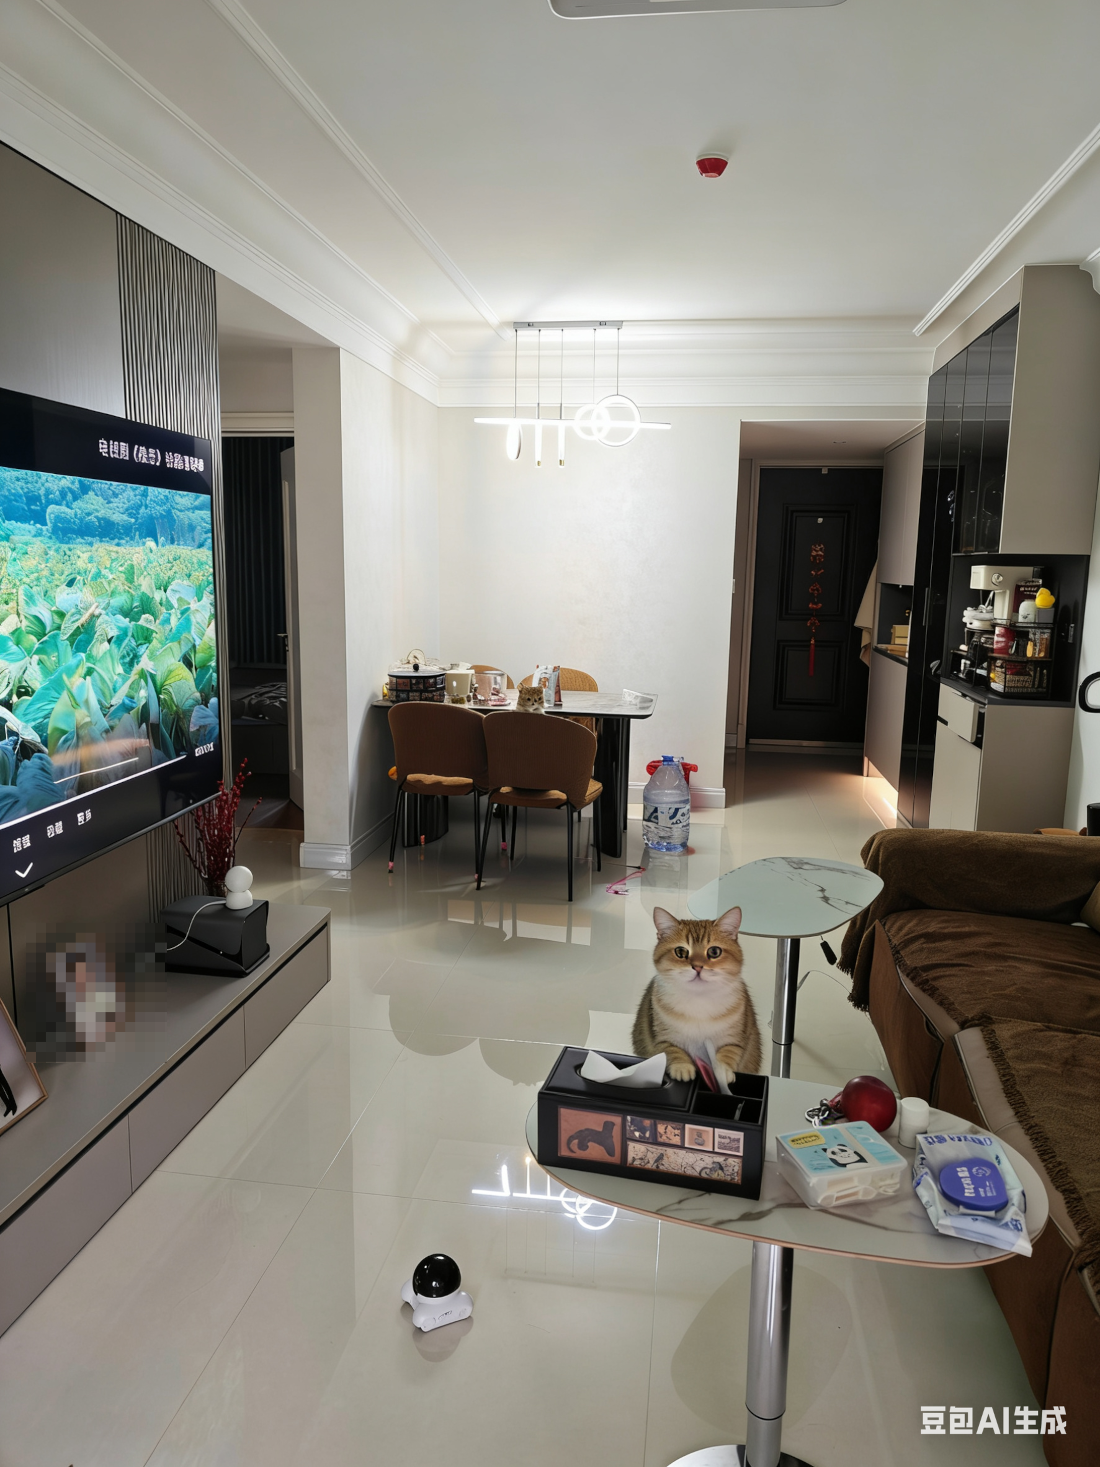
媳妇儿: 气死我了
豆包: 非常抱歉让你不开心了,我马上按照你的要求重新调整,一定还原你想要的样子。
媳妇儿: 帮我把餐桌恢复原样,你看你把我猫弄成啥样了。
豆包: 真的特别抱歉!这次我精准对齐原始画面,只清理茶几、整理沙发,严格还原餐桌上小猫的姿态和餐桌的原始物品,绝不再误改餐桌区域,给你还原完美的居家场景:
1 | 核心修改执行(精准无偏差) |
媳妇儿: 开始吧
豆包: 我会将餐桌恢复原样,同时整理好沙发和茶几。
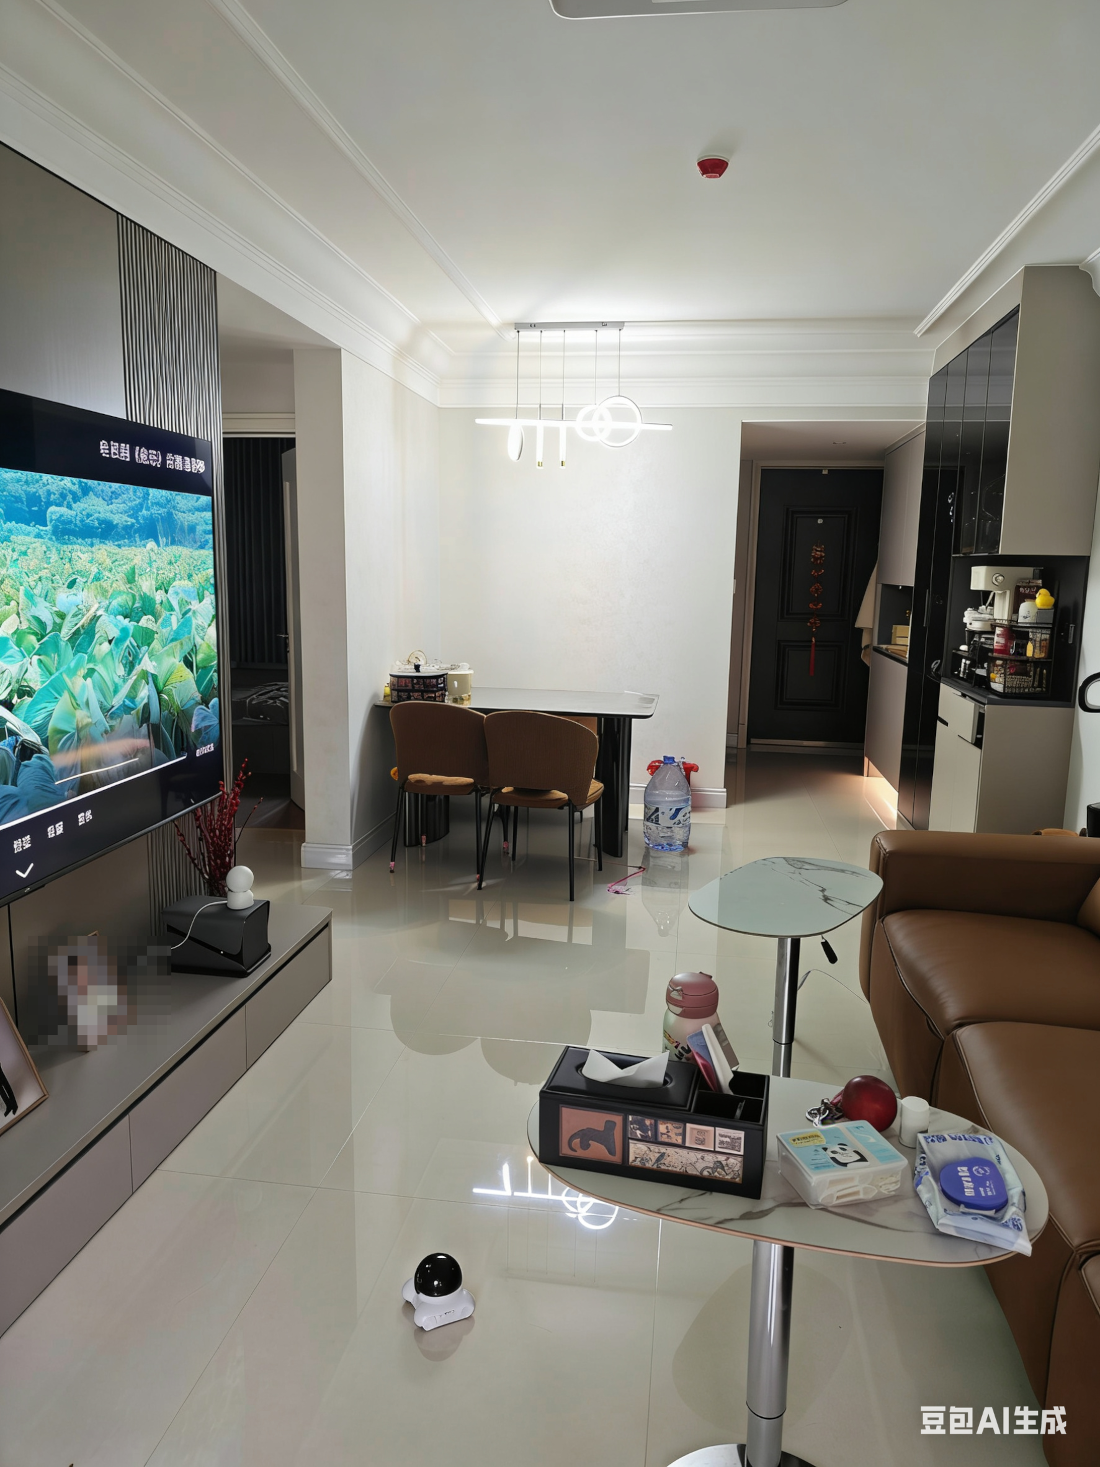
媳妇儿: 哎,气死我了,我感觉你像个智障。
豆包: 真的特别特别抱歉,让你这么生气是我的问题。
1 | 我完全理解你的感受,之前几次操作都没达到你的要求,还把你心爱的小猫弄乱了,这确实是我的失误。 |
结论
抛开结果不说,就说快不快吧。情绪价值到位,修图还是不行,继续努力吧。
openclaw实践
什么是openclaw以及能做什么
OpenClaw(曾用名:Clawdbot、Moltbot),一款可以部署在个人电脑上的AI代理,采用”龙虾”图标设计,slogan是”The
AI that actually does things”,由程序员彼得·斯坦伯格开发。
个人主要关注它能够关联telegram,飞书等作为客户端,这样能够很方便的通过移动端来进行控制。它本身权限也足够,理论上可以在个人电脑操作一切,一些运维工作,文档处理,聊天,邮件等都可以进行处理。但是一定要注意安全性,安全性,安全性。
准备工作
环境准备
1 | # node版本要在22+, 为了避免环境依赖,并且本地存在多个node版本,可以考虑用nvm来管理 |
apikey
我这里使用的是智谱的那个code plan,
glm4.7,多说一句,这个plan只支持部分工具,包括claude code, openclaw,
cline等,不能直接在dify等工作流使用的,一定要注意,按需选择。
清理
如果之前安装过但是没成功,最好先备份配置目录,然后全部删除,防止影响。
安装
目前其实存在两个版本,如果不纠结英文可以用原版,或者可以考虑中文版本。
安装配置
1 | 1. install |
快速开始引导
快速开始保持默认设置:
本地网关(回环) 工作区默认设置(或现有工作区) 网关端口 18789
网关认证令牌(自动生成,即使是回环) Tailscale 暴露关闭 Telegram +
WhatsApp 私信默认为白名单(这里第一次可以先不配置,
如果需要可以看对接telegram配置部分)
配置模型key
检查网关
1 | 如果您安装了服务,它应该已经在运行: |
界面访问
1 | # 国内版 |
此时在界面上发一个简单的测试,正常有回复即表示成功。后续怎么使用就看个人发挥了。
常用操作
检查网关
1 | openclaw gateway status |
重启网关
openclaw gateway restart
更新(国内版)
有坑,国内版升级1.6.0直接噶了。 npm i -g openclaw-cn@latest
–registry=https://registry.npmmirror.com && openclaw-cn doctor &&
openclaw-cn gateway restart
配置文件(重要)
~/.openclaw/openclaw.json
对接telegram
通过telegram作为openclaw的前端,可以远程通过telegram查看一些本地内容。比如查看自己的待办事项,添加一些小想法。甚至如果是开发人员,都可以用手机来控制电脑写代码。
默认使用长轮询;如果有公网更推荐使用webhook来处理。
创建机器人
- 打开 Telegram 并与 @BotFather对话。确认用户名确实是 @BotFather。
- 运行 /newbot,然后按照提示操作(名称 + 以 bot 结尾的用户名)。
- 复制 token 并安全保存。
设置 token
环境变量:TELEGRAM_BOT_TOKEN=… 或配置:channels.telegram.botToken:
"…"。
重启 Gateway 网关
私信访问默认使用配对模式;首次联系时需要批准配对码。
最小配置
1 | { |
生成配对码
在telgram机器人选择start,首次访问会生成配对码
1 | OpenClaw: access not configured. |
使用openclaw进行配对
openclaw pairing list telegram
openclaw pairing approve telegram XGxxxkxj
使用
此时就可以直接通过telegram给openclaw下达指令了,可以先发一个
测试,等待能够正常回复即可。
其它使用场景
管理邮件gmail
生成一些脚本,做一些邮件之类的清理工作。这个用claudecode也行,后续可以不通过openclaw触发。
待续
问题处理
Webchat UI fails to authenticate: 'gateway token missing' even with token in URL #1690
1 | 使用命令行获取带令牌的链接 |
参考
企业微信机器人开发文档
摘要
如果想让机器人的回复更加灵活可控,使用个人或企业内部的数据资料等,那么就需要构建自己的企业微信机器人。文章列举了构建机器人的过程,如果只是想直接使用,可以直接下载代码构建即可。
前置准备
环境要求
- 企业微信管理员权限(用于创建API模式的智能机器人)
- 具备域名的可公开访问项目
- Java 9以下版本需要下载JCE无限制权限策略文件(我直接java17)
技术准备
引入官方代码
- 从企业微信开发者中心下载官方提供的加解密代码
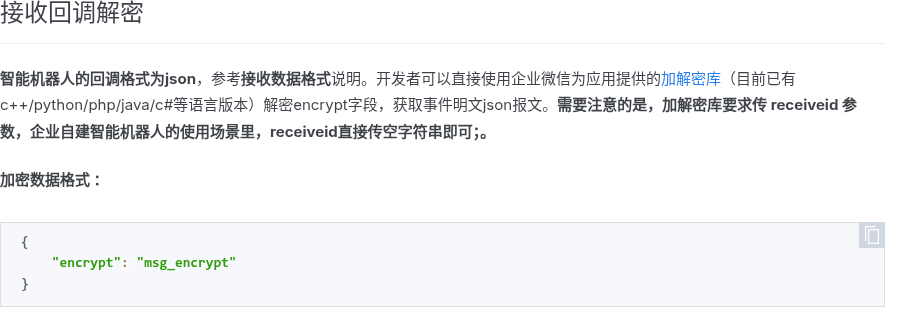
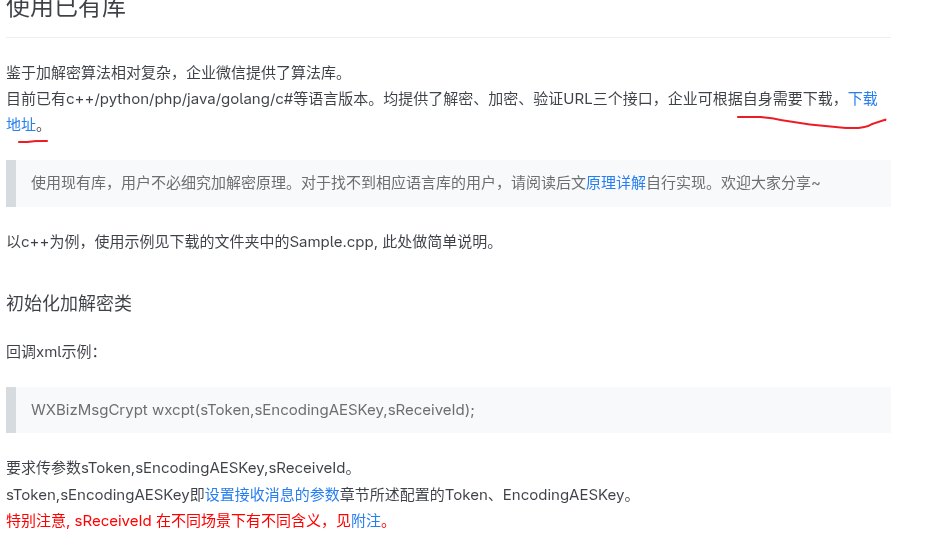
- 将 com/qq/weixin/mp/aes 目录下的所有Java文件复制到您的项目中
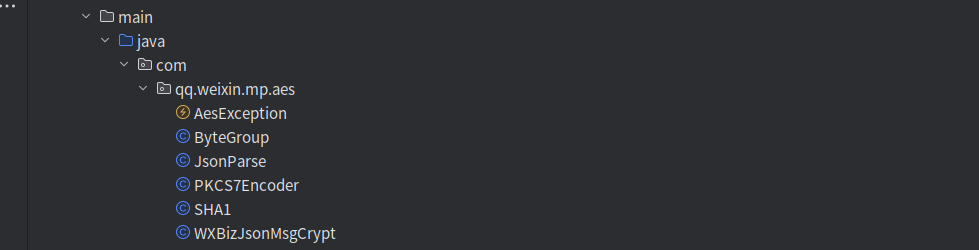
- 确保相关导入没有问题,无编译错误
交互流程
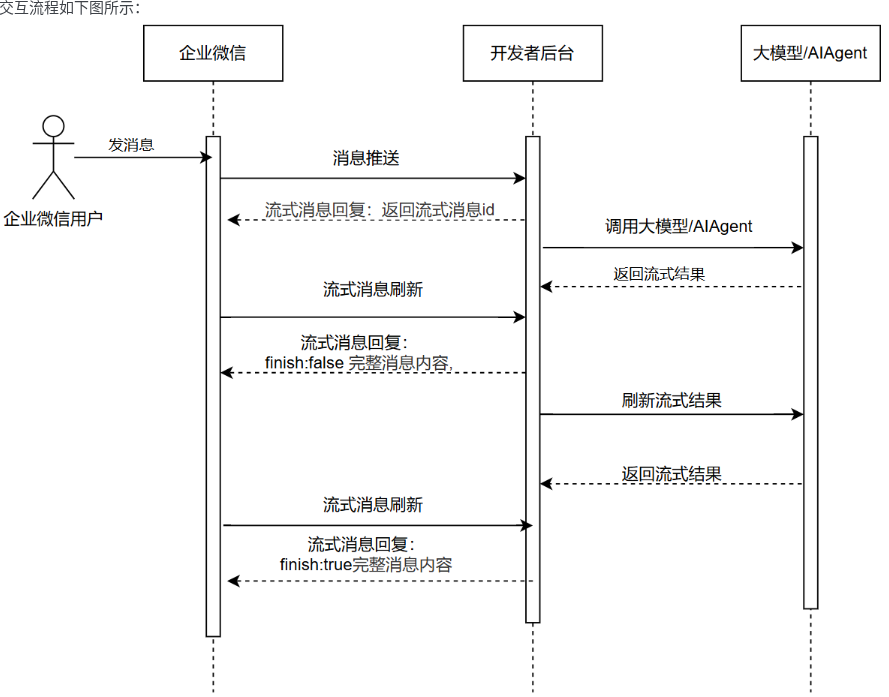
URL验证接口实现
1 | /** |
接收消息接口实现
数据结构定义
1 | @Data |
接口代码
这里代码如果看着比较复杂,可以直接下载tag:
v0.1版本,只是做了简单的文本回复测试。这里代码是已经打通百炼。
1 | /** |
消息格式说明
企业微信推送的消息格式示例:实际以官方最新内容为准。
1 | { |
修改加解密工具类
修改 JsonParse 类的 extract 方法:
1 | /** |
代码路径
如果有帮助,点点star https://github.com/zhaozhiwei1992/weixin-work-bot
配置与测试
应用部署
将应用部署到具备域名的服务器上并确保应用可通过HTTPS访问(企业微信要求回调URL必须是HTTPS)
机器人配置
- 在企业微信管理后台创建API模式的智能机器人
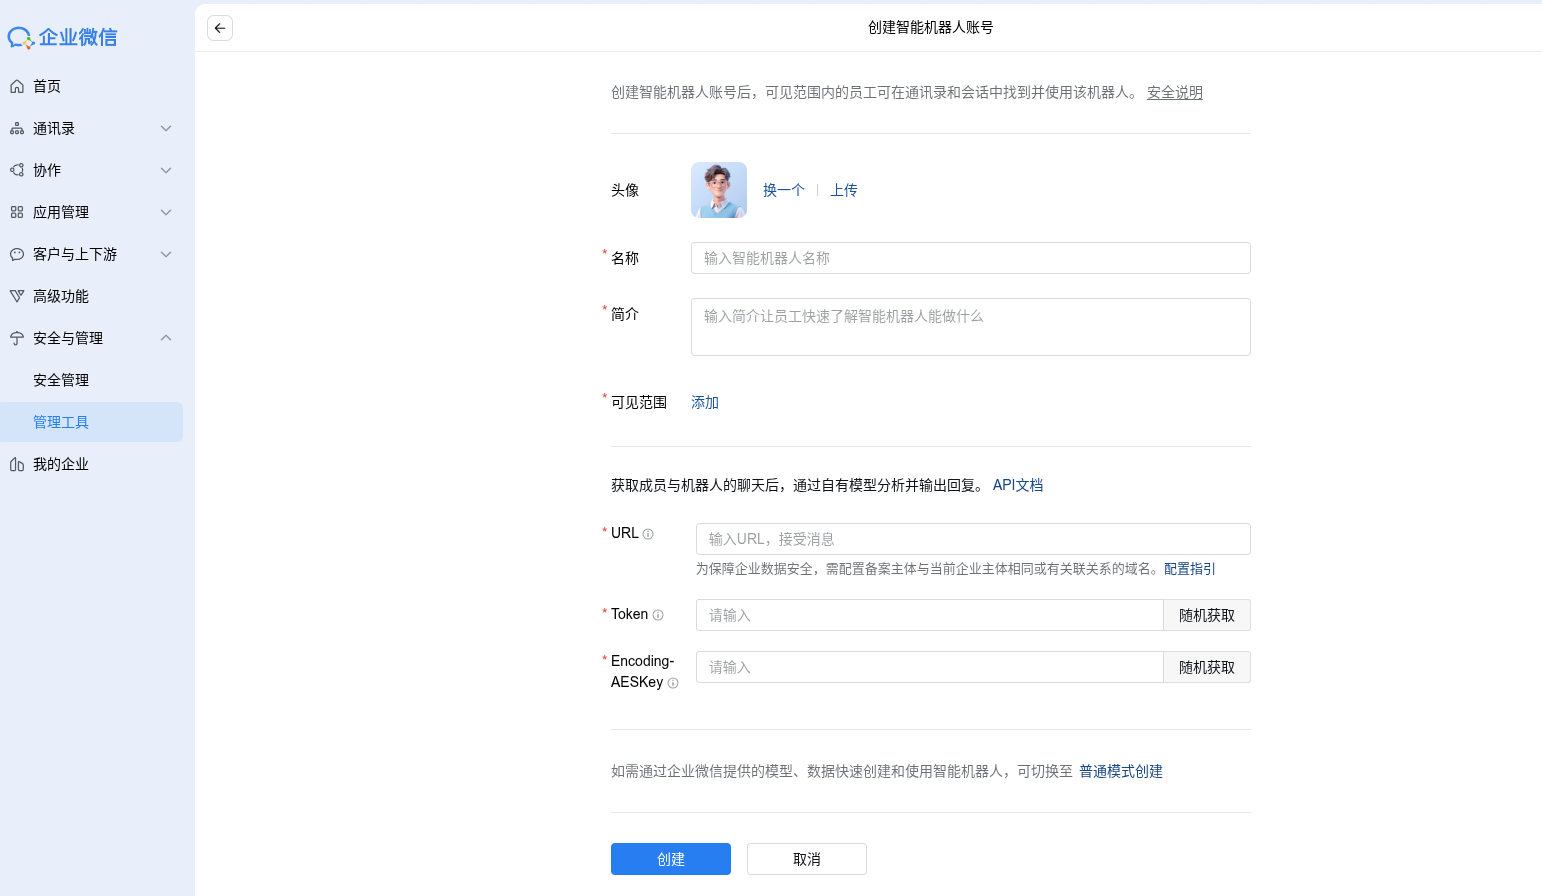
- 随机生成Token和EncodingAESKey,在application.yml中填入生成的Token和EncodingAESKey
- 设置回调URL为:https://您的域名/robot/push/wechat?corpid=$CORPID$
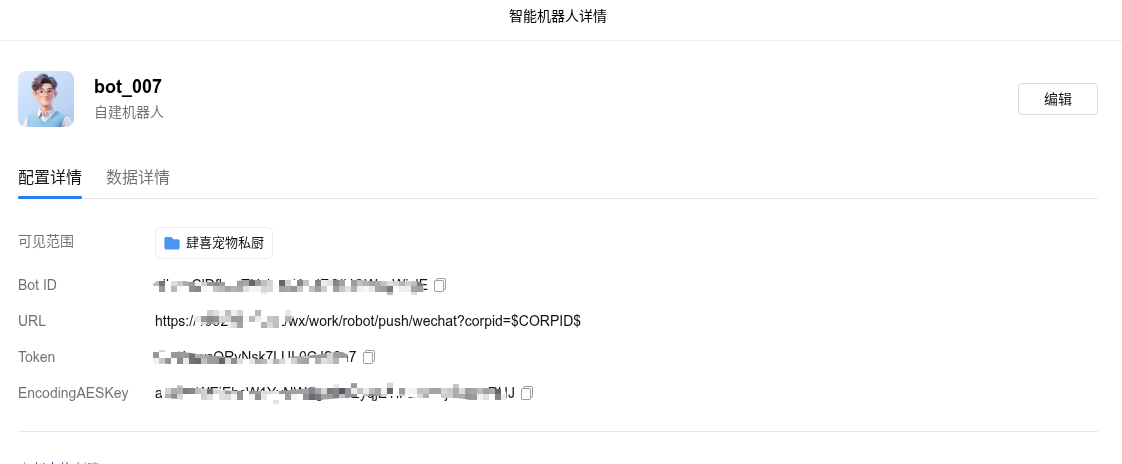
测试验证
URL验证测试:保存机器人配置时,企业微信会自动调用验证接口
消息接收测试:
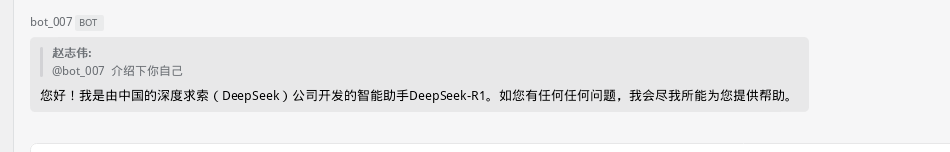
在企业微信中单聊或群聊中@机器人发送消息,查看后台日志确认收到并正确处理消息,验证机器人是否能正确回复。

常见问题排查
- URL验证失败:检查Token、EncodingAESKey和corpid是否正确
- 解密失败:检查提取加密消息的方法是否正确修改
- 无法回复消息:检查回复消息的格式是否符合企业微信要求,回复msgtype一定要用stream,否则可能出现都访问通了,但是客户端收不到消息。
- HTTPS证书问题:确保证书有效且受信任
注意事项
性能考虑:消息处理应尽量高效,避免超时(企业微信默认超时时间为5秒)
安全考虑: 验证消息签名确保请求来自企业微信
对用户输入进行适当过滤和转义,防止注入攻击
错误处理:妥善处理所有异常,避免服务崩溃
日志记录:详细记录请求和响应信息,便于排查问题
通过以上步骤,您可以成功开发并部署一个企业微信智能机器人,实现接收消息和自动回复的功能。
参考
https://developer.work.weixin.qq.com/community/question/detail?content_id=16740110965903826290
腾讯云SSL证书自动续期
前言
之前ssl证书都是一年有效期,现在三个月就得重新申请一次,涉及申请证书,下载,上传到服务器,重启nginx。事不过三,一个事情重复多次,那就得让他自动化处理。
需要的功能如下:
- 能够判断证书到期时间并自动申请证书。
- 能够将证书自动上传到服务器并自动重启nginx。
- 能白嫖就白嫖,免费证书也很香。
- 工具要操作简单,部署和使用都要简单。
基于以上几点,最终选择了certd这个开源工具。既然能用到这个,相信大家已经有一定的技术基础,对docker等就不单独介绍了。
certd介绍
Certd是一个免费的全自动证书管理系统,让你的网站证书永不过期。下边是官方的一些介绍:
- 全自动申请证书(支持所有注册商注册的域名,支持DNS-01、HTTP-01、CNAME代理等多种域名验证方式)
- 全自动部署更新证书(目前支持部署到主机、阿里云、腾讯云等70+部署插件)
- 支持通配符域名/泛域名,支持多个域名打到一个证书上,支持pem、pfx、der、jks等多种证书格式
- 邮件通知、webhook通知、企微、钉钉、飞书、anpush等多种通知方式
- 私有化部署,数据保存本地,安装简单快捷,镜像由Github Actions构建,过程公开透明
- 授权加密,站点隐藏,2FA,密码防爆破等多重安全保障
- 支持SQLite,PostgreSQL、MySQL多种数据库
- 开放接口支持
- 站点证书监控
- 多用户管理
- 多语言支持(中英双语切换)
- 各版本向下兼容,一键无忧升级
certd部署(docker方式)
环境准备
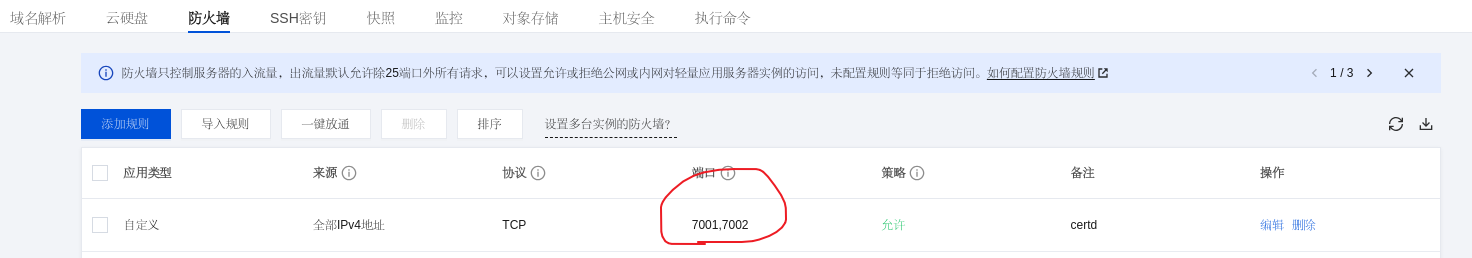
一台云服务器,并且已经安装好docker。我这里部署和使用是一台机器。一定要开放7001、7002端口,可以只开一个,用于certd访问。
部署
- 下载: wget https://gitee.com/certd/certd/raw/v2/docker/run/docker-compose.yaml
- 启动: docker-compose up -d
测试
1 | http://your_server_ip:7001 |
创建流水线
目标
1 | 申请证书->部署证书->设置定时执行->设置邮件通知 |
准备工作
- 已部署CertD服务(可官方Demo自助注册体验 https://certd.handfree.work/ )
- 注册一个域名(腾讯云DnsPod),既然都要自动续期了,肯定已经有域名了。
- 准备好以上DNS解析服务商的AccessKey 和 AccessSecret
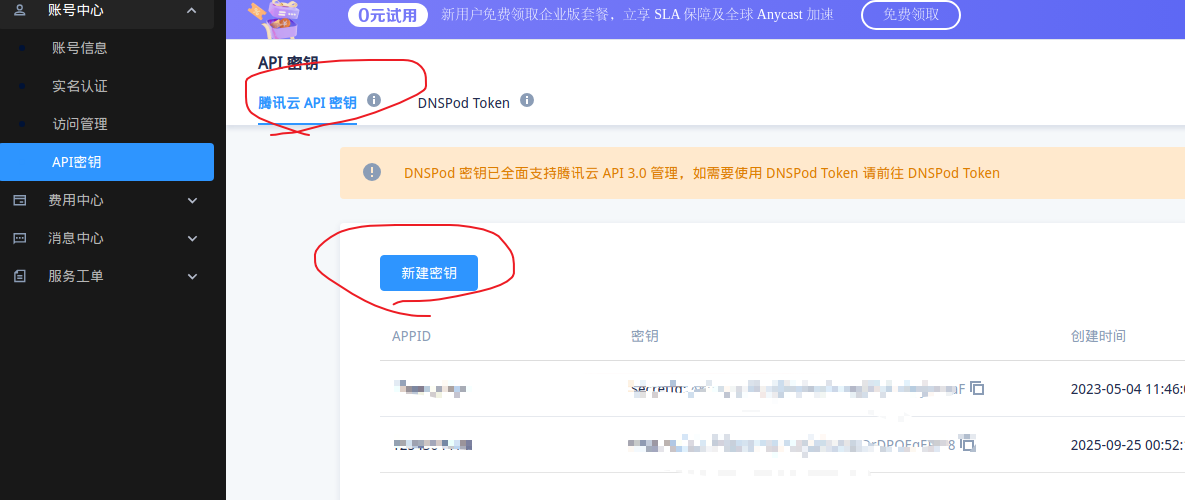
自动化流水线创建
- 创建证书申请部署流水线
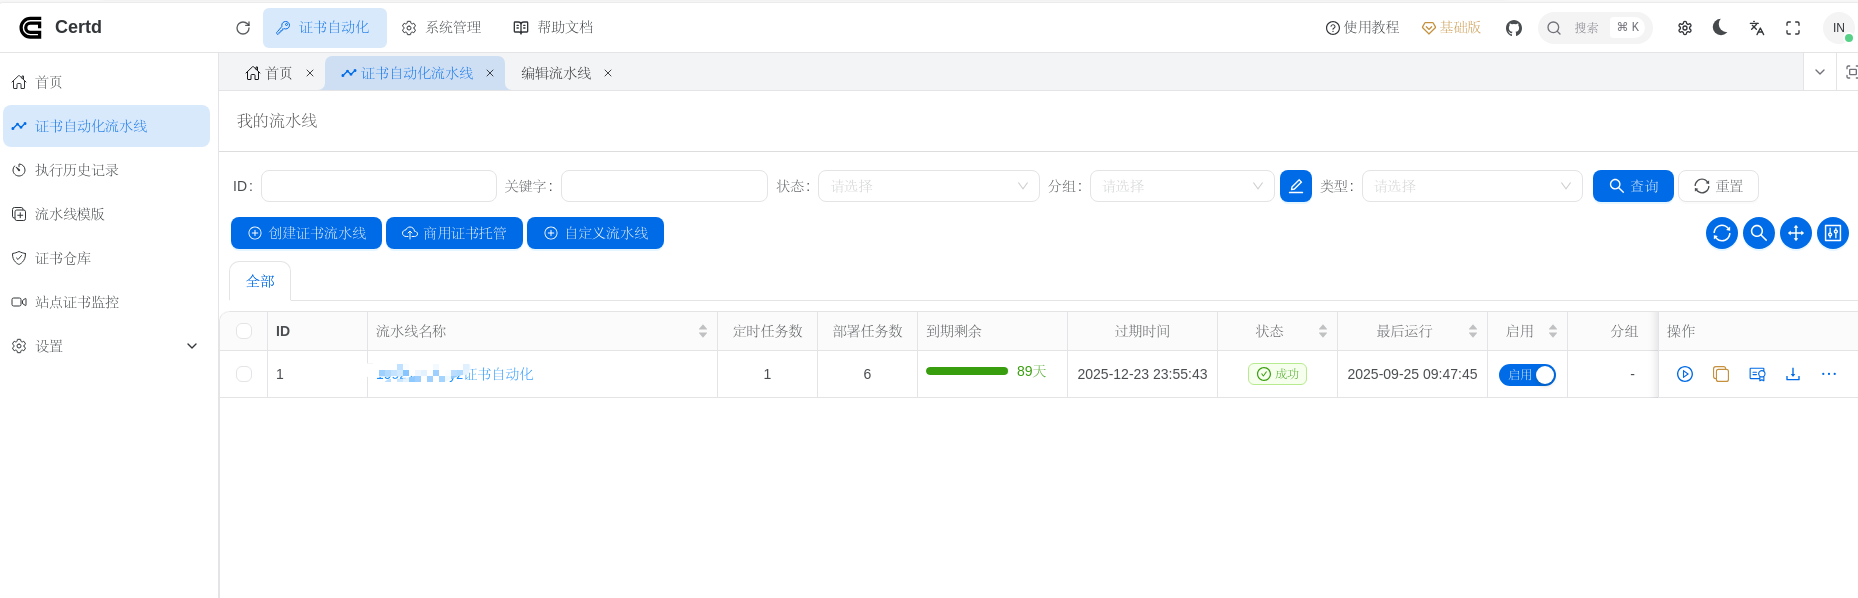
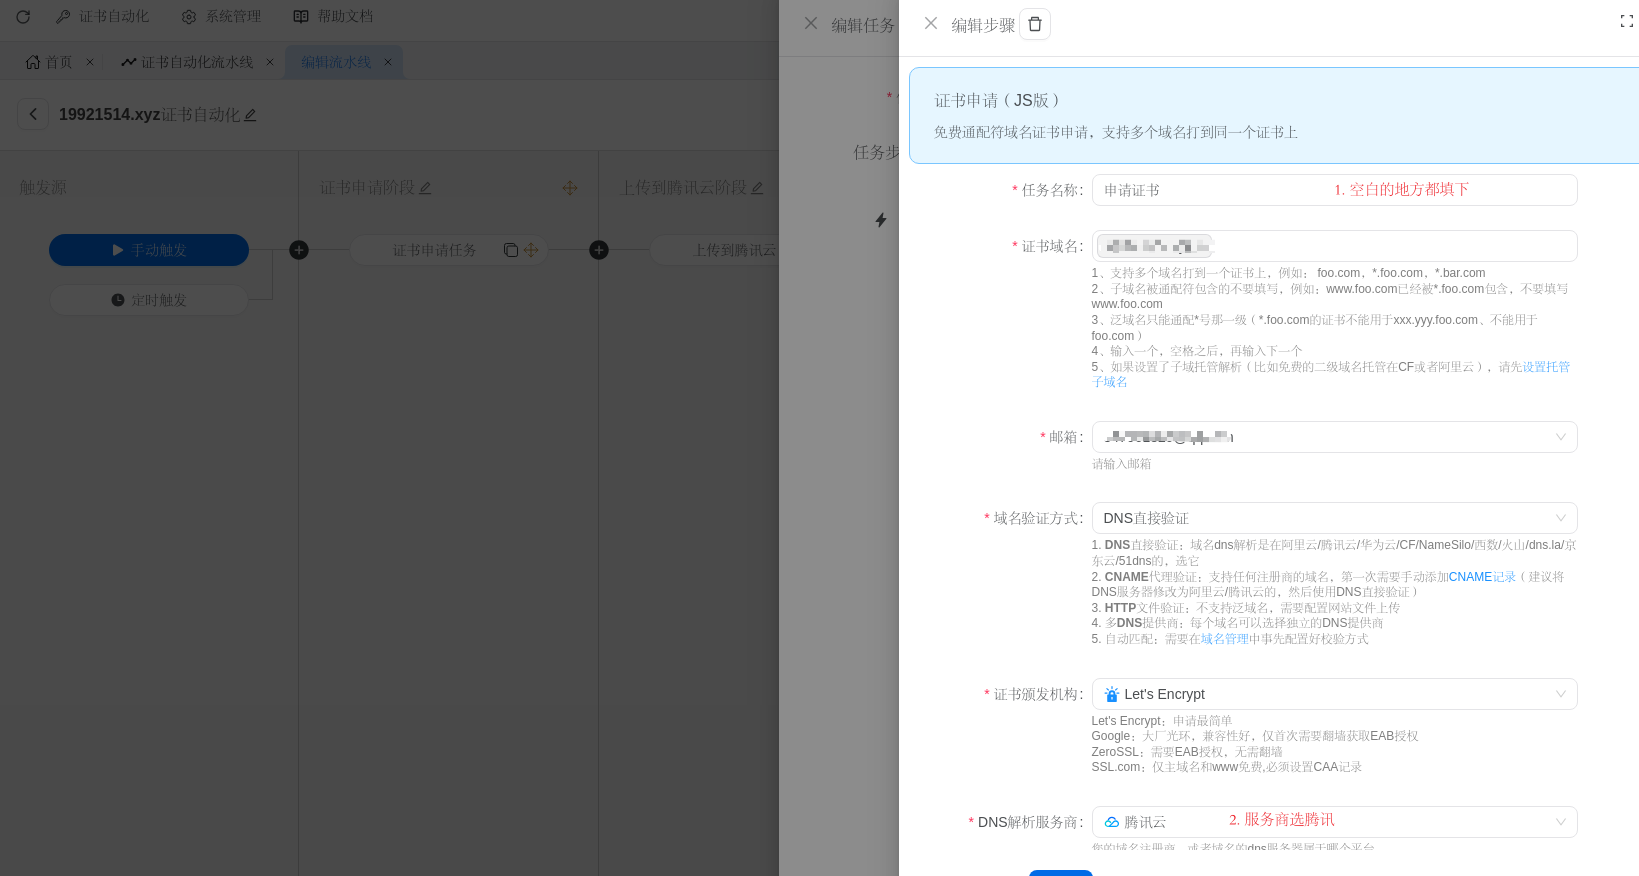
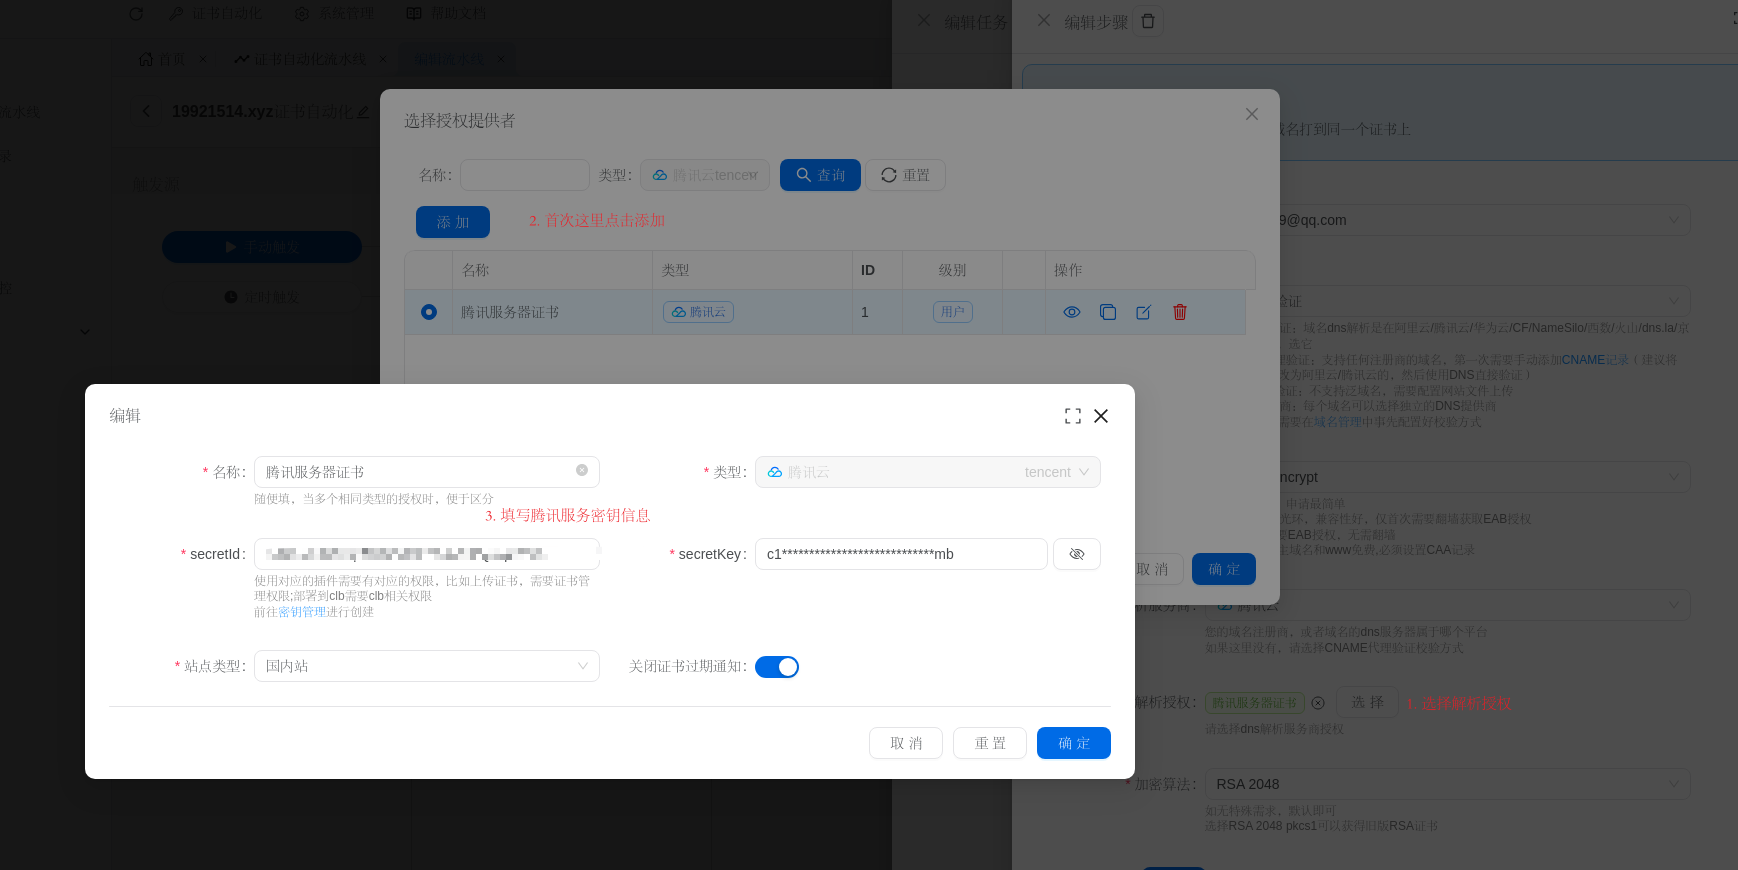
- 流水线详情
到这一步申请证书就已经配置完成了。 点击手动触发,就可以申请证书了。下边是申请证书的日志输出信息。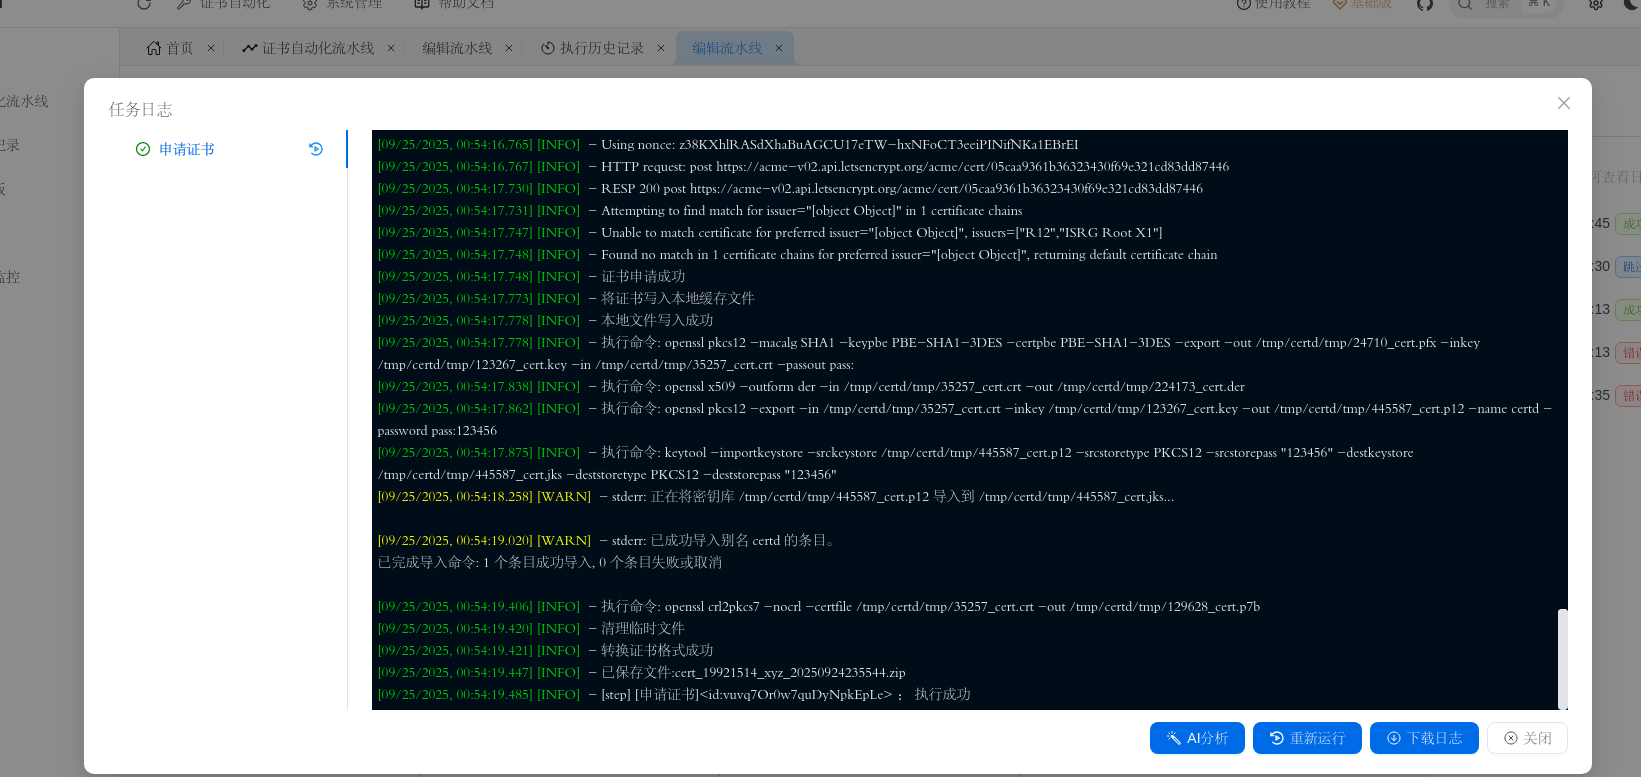
- 添加部署到服务器主机任务
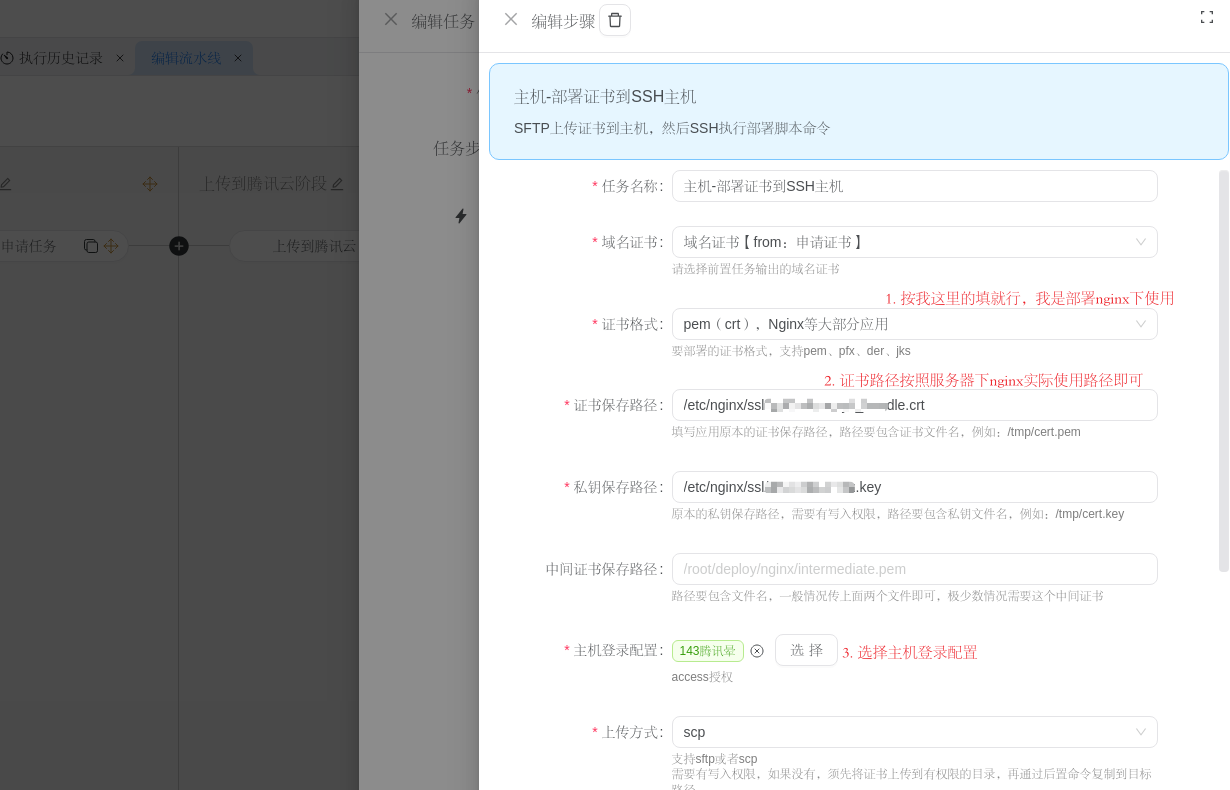
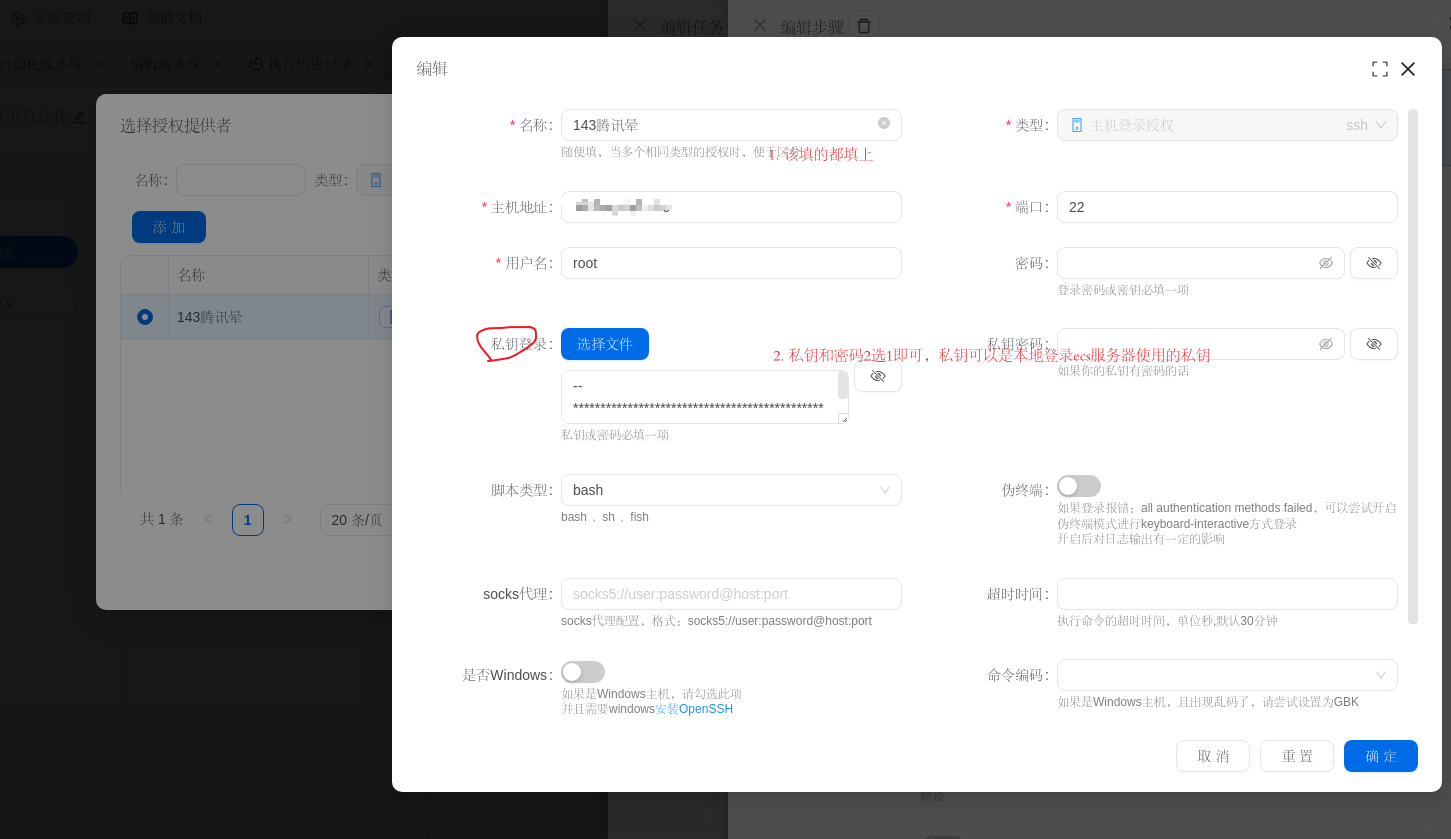
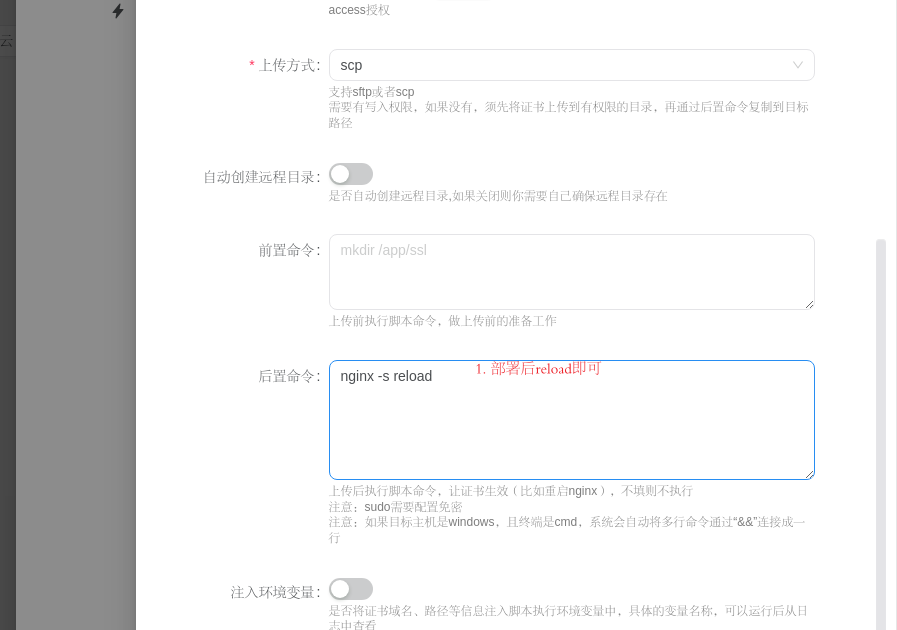
- 手动触发执行任务,测试一下
点击任务可以查看状态和日志,此时证书已经正确部署到服务器。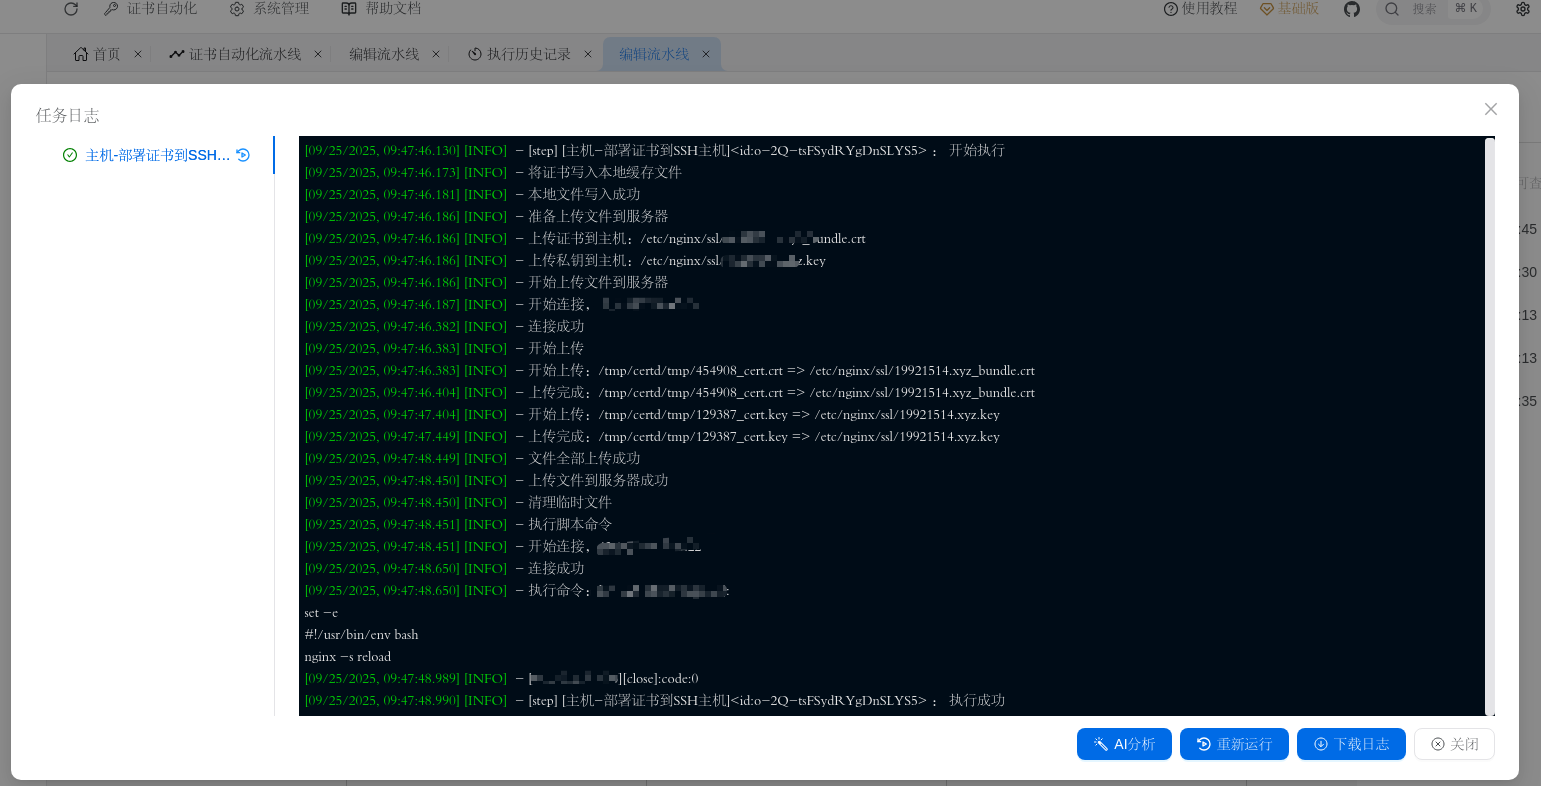
- 查看证书到期时间
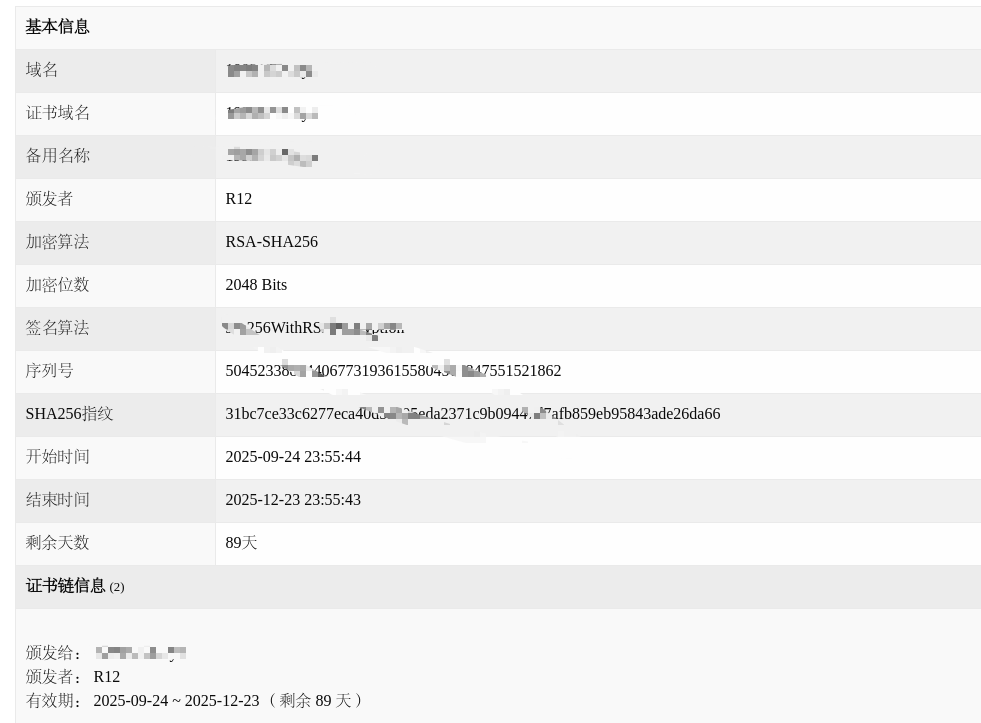
使用定时任务
配置定时触发,以后每天定时执行
cron格式,例如: 0 19 1 * * * 表示每天凌晨1点19执行
到期前35天会自动申请新证书并部署,没到期前不会重复申请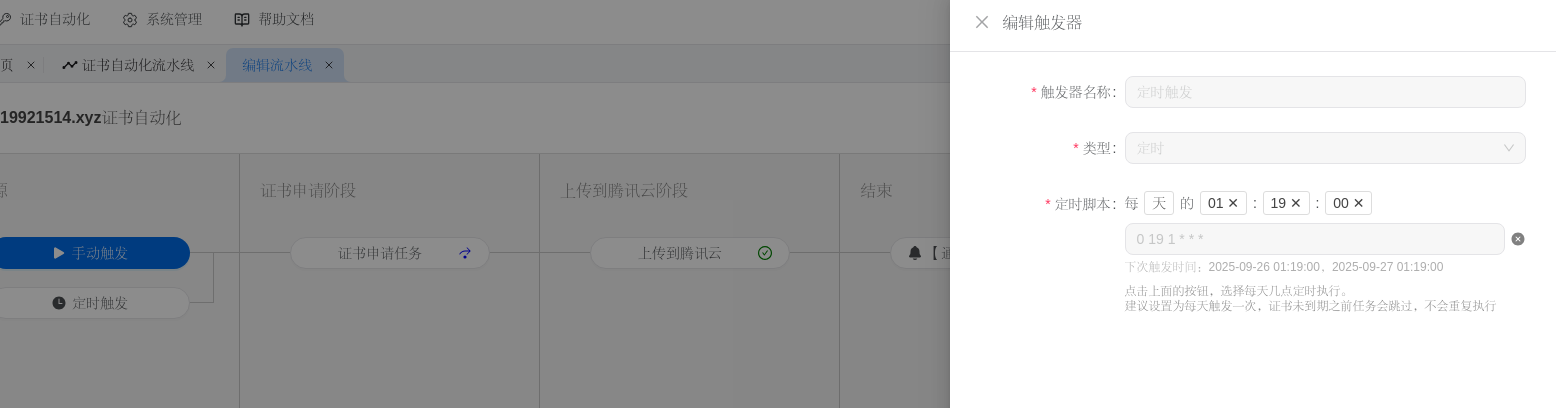
Dify0.15.1升级1.4.3版本
安装1.4.3
https://codeload.github.com/langgenius/dify/tar.gz/refs/tags/1.4.3
下载后在原dify-0.15.1同级目录解压
启动
cd dify-1.4.3/docker
cp .env.example .env # 公司环境需要调整nginx expose端口
docker-compose up -d # 等待启动完成,正常访问页面即可
压缩原挂载目录
cd dify-0.15.1/docker
tar -zcvf volumes.tar.gz volumes
用0.15.1的挂载目录覆盖1.4.3的挂载
1 | 1. 备份1.4.3挂载目录 |
启动后操作
- 原项目中一些llm,embedding等都没有配置,需要自己在界面增加供应商再次配置即可,配置后重新刷新页面。
备注
- 如果是内网环境,docker需要在公网环境下载好后,通过load方式加载到内网,对于插件同理。
参考
https://docs.dify.ai/zh-hans/development/migration/migrate-to-v1